Todo estudo de demanda por transporte começa com uma pergunta simples: quantas pessoas saem de cada lugar e para onde elas vão. A matriz Origem e Destino (O/D) é a tabela que guarda essa resposta. Neste post explico como ela é montada e como ler suas linhas, colunas e diagonal. Também mostro por que hoje os mesmos dados costumam ser guardados em outro formato, o empilhado.
Antes da matriz: zonas e centróides
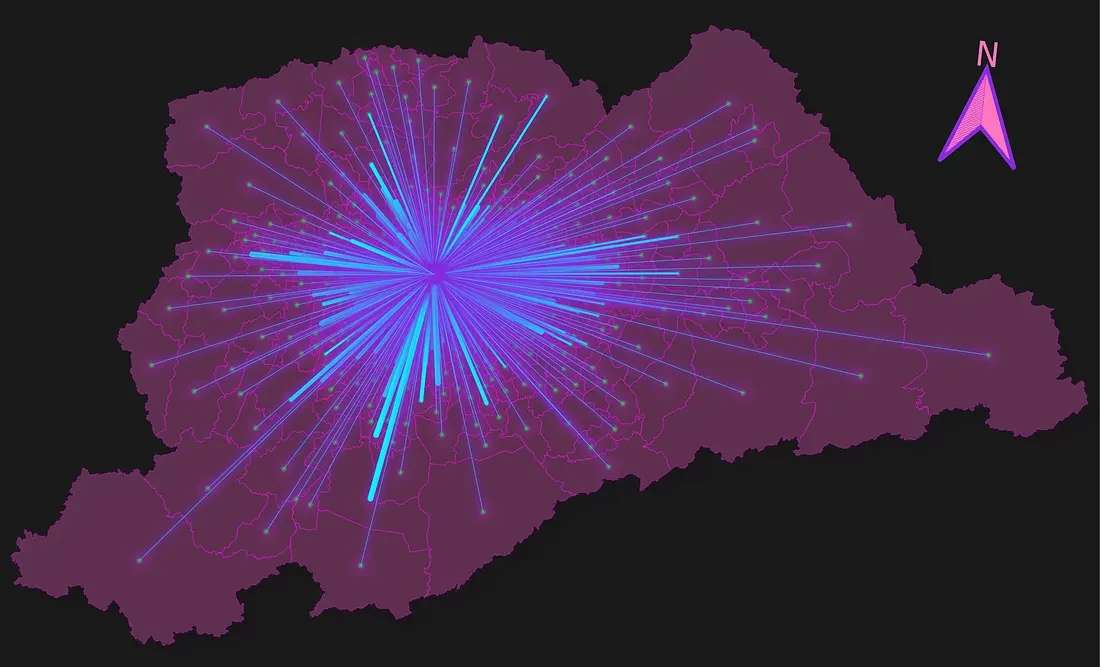
Para contar viagens, primeiro se divide o território em Zonas de Análise de Tráfego (TAZ, do inglês Traffic Analysis Zones). Cada zona é uma área tratada como unidade. No modelo, ela é representada por um único ponto, o centróide, de onde as viagens “saem” e onde “chegam”.
No Brasil, a referência prática é a Pesquisa Origem e Destino do Metrô de São Paulo. Em qualquer pesquisa, a escolha das zonas não é neutra: o que fica dentro de uma zona some da análise entre zonas.
O que é a matriz O/D
Formalmente, a matriz O/D é uma tabela quadrada de dupla entrada, com tantas linhas e colunas quanto zonas existem (n x n). Cada célula T_ij guarda o volume de viagens que partem da zona de origem i e terminam na zona de destino j. Esse volume vale para um período definido (IPEA). O período importa: uma matriz do pico da manhã e outra do dia inteiro descrevem fenômenos diferentes.
A modelagem clássica de demanda tem quatro etapas: geração de viagens, distribuição, divisão modal e alocação na rede. A matriz O/D é o produto da segunda etapa, quando as viagens geradas em cada zona são distribuídas entre os destinos possíveis (MIT, aula sobre o modelo de quatro etapas).
Como ler: linhas, colunas e diagonal
A convenção de leitura é estável: linhas são origens, colunas são destinos. Com três zonas, A, B e C, a tabela fica assim:
| Origem \ Destino | A | B | C | Total produzido |
|---|---|---|---|---|
| A | T_AA |
T_AB |
T_AC |
O_A |
| B | T_BA |
T_BB |
T_BC |
O_B |
| C | T_CA |
T_CB |
T_CC |
O_C |
| Total atraído | D_A |
D_B |
D_C |
T |
A diagonal principal (T_AA, T_BB, T_CC, onde origem e destino coincidem) registra só as viagens intrazonais: deslocamentos que começam e terminam dentro da mesma zona. As demais células guardam as viagens interzonais. O relatório do IPEA chama atenção para o peso dessas viagens retidas na diagonal. Esse peso depende do desenho do zoneamento.
Os totais marginais mostram os polos
Somar uma linha dá o total de viagens produzidas pela zona de origem: O_i = Σ_j T_ij. Somar uma coluna dá o total de viagens atraídas pela zona de destino: D_j = Σ_i T_ij. A soma de todas as células é o total de viagens da área de estudo, e ela é a mesma pelas linhas ou pelas colunas (MIT; TU Delft).
Na prática, esses totais respondem a uma pergunta frequente de planejamento: quais zonas geram muitas viagens e quais atraem muitas. Em geral, as que geram são bairros residenciais, e as que atraem são centros de emprego e serviço.
Produção-Atração não é Origem-Destino
Existe uma distinção que confunde muita gente. A matriz de Produção-Atração (PA) organiza as viagens a partir do domicílio de quem viaja, sem importar o sentido do percurso. Assim, a ida ao trabalho e a volta para casa contam para a mesma zona produtora. Já a matriz O/D é direcional e presa a um recorte de tempo.
Por isso a matriz O/D do pico da manhã é assimétrica, com fluxo forte da periferia para o centro. A do pico da tarde mostra o movimento inverso. Quem usa uma matriz PA como se fosse O/D perde essa direção.
Ajustar a matriz aos totais observados
Uma matriz vinda de amostra ou de modelo raramente bate com as contagens reais de tráfego ou de passageiros. Para compatibilizar as duas coisas, usa-se o balanceamento biproporcional, conhecido como Iterative Proportional Fitting (IPF) ou método de Furness e Fratar. Ele reescala linhas e colunas alternadamente até os totais marginais da matriz convergirem para os volumes observados (MIT, aula sobre inferência O/D; IPEA).
Outra família de métodos é o modelo gravitacional duplamente restrito. Ele distribui as viagens segundo a impedância, isto é, o custo de ir de uma zona a outra (tempo, distância ou custo generalizado). Ao mesmo tempo, respeita os totais de produção e de atração (TU Delft). As mesmas notas da TU Delft também tratam de métodos que atualizam a matriz por fatores de crescimento.
De onde vêm os dados
As pesquisas domiciliares decenais, como a do Metrô de São Paulo, seguem como a verdade de campo usada para expandir a amostra estatisticamente. Elas vêm sendo combinadas com microdados de bilhetagem eletrônica (cartões inteligentes, os smart cards), que registram cada embarque. Uma dissertação da Escola Politécnica da USP mostra como montar matrizes O/D do transporte público a partir desses registros, encadeando as viagens de cada cartão.
Fontes novas trazem seus próprios cuidados. Um estudo com dados de rede celular em Norrköping, na Suécia, comparou a demanda inferida dos celulares com o modelo de demanda do município. A concordância foi fraca no zoneamento original. Ela passou a ser significativa quando as viagens foram agregadas em menos zonas. Os autores também observaram diferenças sistemáticas entre as matrizes conforme o método usado para extrair as viagens.
O formato empilhado (stacked)
A tabela n x n é a forma clássica de mostrar a matriz, mas não é a forma mais prática de guardá-la. No formato empilhado (também chamado de longo, ou tidy), cada linha da tabela é um par origem-destino. O fluxo e os outros atributos ficam em colunas explícitas:
| origem | destino | viagens | modo | período |
|---|---|---|---|---|
| A | B | T_AB |
ônibus | pico manhã |
| A | C | T_AC |
ônibus | pico manhã |
| B | A | T_BA |
automóvel | pico manhã |
O relatório da Federal Highway Administration (FHWA) documenta essa passagem entre dados tabulares de pesquisa e os arquivos de matriz usados por softwares como o TransCAD. O formato empilhado se encaixa direto em bancos de dados relacionais e em bibliotecas de ciência de dados como Pandas, GeoPandas e dplyr. Ele também permite descartar os pares sem viagem, em vez de guardar uma célula com zero.
Além disso, o formato empilhado é a entrada natural para gerar linhas de desejo no QGIS. Cada linha da tabela vira um segmento ligando dois centróides, com espessura proporcional ao fluxo.
A própria forma da matriz está em discussão na pesquisa. Um artigo na IEEE Transactions on Intelligent Transportation Systems argumenta que a matriz O/D tradicional pode perder informação geográfica. Como alternativa, os autores propõem outra estrutura, o tensor O/D, para alimentar modelos de previsão.
Um limite deste post: o material que reuni não traz medição do custo de memória ou de processamento de cada formato. Por isso não comparo desempenho aqui, só a organização dos dados.
Para levar
Ao abrir uma matriz O/D, confira quatro coisas:
- o zoneamento usado;
- o período que ela cobre;
- se a tabela é PA ou O/D;
- se os totais marginais foram ajustados a contagens observadas.
Se o próximo passo for análise em Python, em R ou num sistema de informação geográfica, guarde os dados no formato empilhado. Deixe a tabela n x n para a hora de apresentar.
Da matriz às linhas de desejo: o plugin Desire Lines
Foi para esse último passo que desenvolvi o Desire Lines, um plugin que constrói linhas de desejo a partir de uma matriz O/D. Ele trabalha com as duas versões discutidas neste post: a tabela n x n e o formato empilhado. Assim, a matriz pode entrar no formato em que ela chegou até você, e cada par origem-destino vira uma linha ligando dois centróides.