O arquivo de escolas do PISA 2025 traz 1.053 linhas para o Brasil. Expandidas pelo peso amostral, essas 1.053 escolas representam uma estimativa de 51.846,5 escolas. Contando linha a linha, a rede pública é 83,57% da amostra brasileira; expandindo pelo peso, ela é 76,67%. O dado é o mesmo, a coluna é a mesma, e o deslocamento de -6,90 pontos percentuais entre os dois números não vem de nenhuma correção: vem de qual dos dois objetos se está medindo.
O PUF é amostra, não cadastro
O Public Use File do PISA é o arquivo que a OCDE publica com as escolas e os estudantes efetivamente pesquisados em cada ciclo. Ele não é o cadastro de escolas de nenhum país. As 1.053 linhas do Brasil no arquivo da escola são escolas amostradas, e as 30.140 linhas do Brasil no arquivo do estudante são estudantes amostrados na idade-alvo do PISA.
Contagem de linha, portanto, não é contagem de escola. Somar as linhas de uma categoria e dividir pelo total de linhas responde a uma pergunta sobre a amostra (“que fração das escolas pesquisadas é pública?”), não sobre o país (“que fração das escolas brasileiras com alunos de 15 anos é pública?”). As duas perguntas têm respostas diferentes, e a segunda exige o peso.
O que o peso faz
Cada linha do PUF carrega o peso final do desenho amostral: W_NRASCHBWT no arquivo da escola (rótulo FINAL TRIMMED NONRESPONSE ADJUSTED SCHOOL WEIGHT) e W_FSTUWT no arquivo do estudante (FINAL TRIMMED NONRESPONSE ADJUSTED STUDENT WEIGHT). O peso diz quantas unidades da população cada linha representa.
O ponto que importa é que esse peso varia de linha para linha. No Brasil, a média é de 49,2369 escolas estimadas por escola amostrada, mas é média, não constante: a amostra não é autoponderada. Como escolas de estratos diferentes entram com pesos diferentes, a composição da amostra e a composição da estimativa populacional não coincidem. É por isso que a fatia da rede pública cai e a da rede privada sobe quando se troca a contagem pela expansão: a amostra sobrerrepresenta a rede pública em relação ao peso que ela tem na população estimada de escolas.
Escolas: as quatro categorias
A pergunta que classifica a rede é SC013Q01TA, respondida pelo diretor da escola. Ela tem quatro respostas com linha no Brasil, e as quatro entram na tabela abaixo, inclusive as duas de não resposta, porque tirá-las mudaria o denominador sem avisar.
Rede (SC013Q01TA) |
Amostra | % amostra | Ponderado (W_NRASCHBWT) |
% ponderado | Δ pp |
|---|---|---|---|---|---|
| Pública | 880 | 83,5708% | 39.748,7131 | 76,6661% | -6,9047 |
| Privada | 116 | 11,0161% | 9.960,6427 | 19,2118% | +8,1957 |
| Não administrada | 43 | 4,0836% | 1.761,8142 | 3,3981% | -0,6855 |
| Sem resposta | 14 | 1,3295% | 375,3325 | 0,7239% | -0,6056 |
| Total | 1.053 | 100% | 51.846,5025 | 100% |
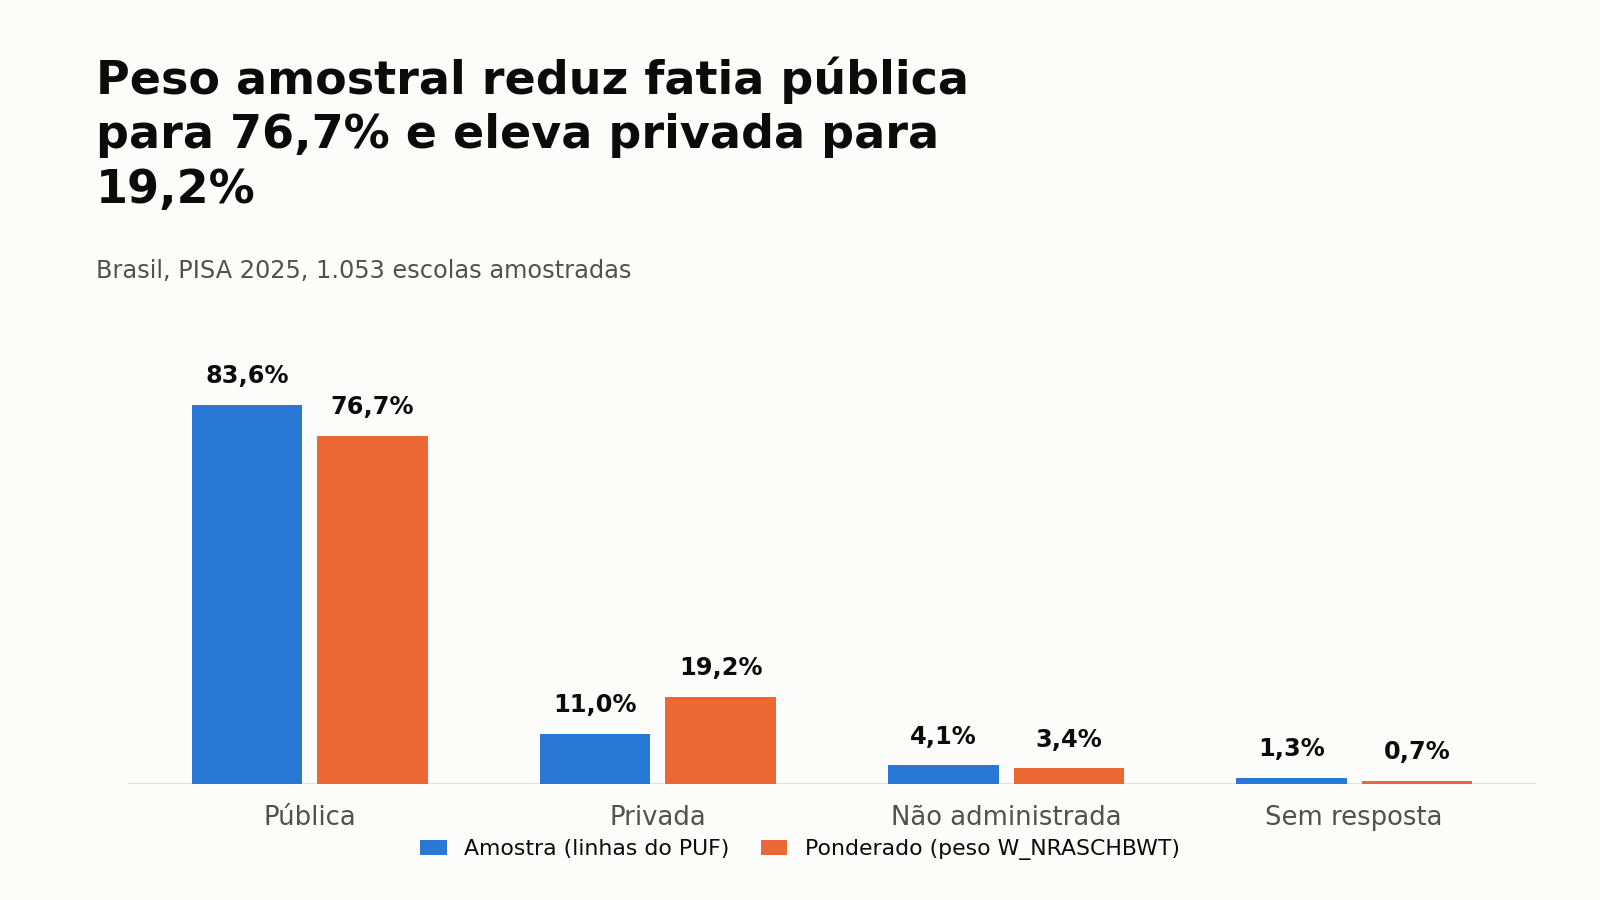
A rede privada é o caso mais visível: 11,02% das linhas, 19,21% da estimativa expandida, um deslocamento de 8,20 pontos percentuais. Quem citar o primeiro número como “a fatia de escolas privadas do Brasil no PISA” estará descrevendo a amostra da OCDE, não o país.
Estudantes: o mesmo mecanismo mexendo pouco
O mesmo cálculo no arquivo do estudante, com o peso W_FSTUWT, produz um deslocamento bem menor: as 30.140 linhas do Brasil representam 2.184.649,9 estudantes estimados. A não resposta de sexo no Brasil é zero, então as linhas se dividem em duas categorias apenas.
Sexo (ST004D01T) |
Amostra | % amostra | Ponderado (W_FSTUWT) |
% ponderado | Δ pp |
|---|---|---|---|---|---|
| Female | 15.413 | 51,138% | 1.093.288,3685 | 50,0441% | -1,0939 |
| Male | 14.727 | 48,862% | 1.091.361,5331 | 49,9559% | +1,0939 |
| Total | 30.140 | 100% | 2.184.649,9016 | 100% |
O fator médio de expansão aqui é de 72,4834 estudantes estimados por estudante amostrado, e a composição por sexo se move 1,09 ponto percentual, contra os 8,20 da rede privada. A leitura é direta: o peso desloca a composição na medida em que a característica observada se correlaciona com o peso. Na dimensão sexo a amostra brasileira está perto de autoponderada, então ponderar muda pouco. Na dimensão rede não está, e ponderar muda bastante. O mecanismo é o mesmo nos dois casos; o que muda é o quanto ele tem para mover.
Sobre qual denominador
Todos os percentuais acima são calculados sobre o total de escolas amostradas do Brasil, as 1.053, com as 57 que não informaram rede incluídas no denominador. Essa escolha está declarada porque ela altera o resultado: sobre apenas as 996 escolas que informaram rede, a fatia pública do Brasil na amostra é 88,3534%, e não 83,5708%.
Isso já é achado registrado nesta base. A pergunta de rede não é administrada em todos os sistemas: 8 países e economias têm 100% das escolas amostradas sem resposta a ela, e no Canadá a troca de denominador move a fatia pública em 24,65 pontos percentuais. Um percentual de rede pública deste arquivo que não diga sobre qual denominador foi calculado é um número sem leitura possível.
As ressalvas, sem suavizar
Esta apuração descreve o que o peso amostral faz com a composição do arquivo, e nada além disso. Seis limites, em ordem:
O PUF é amostra, não cadastro. As contagens de linha são de escolas e estudantes pesquisados pela OCDE. Nenhum número de linha deste post deve ser lido como total de estabelecimentos ou de matrículas do país.
A rede vem da declaração do diretor. A classificação pública/privada sai da resposta a SC013Q01TA no questionário da escola, não de cadastro administrativo. Ela não é diretamente comparável com a classificação de rede do Censo Escolar do INEP, que tem outra origem e outra regra.
Um ciclo só. Estas bases cobrem estritamente o PISA 2025. Toda comparação aqui é amostral contra ponderado dentro do mesmo ciclo, nunca entre ciclos. Comparar com o ciclo anterior do PISA, ou com qualquer ciclo mais antigo, exige baixar os arquivos daquele ciclo e refazer a harmonização, o que estes arquivos não permitem isoladamente.
O denominador está declarado, e importa. Os percentuais são sobre o total de escolas amostradas, incluídas as que não informaram rede. Sobre o informado, os números são outros, e a seção acima dá os dois.
Proficiência está fora do escopo. Nenhuma nota do PISA entra nesta apuração. Os plausible values não foram usados, e estimativa oficial de proficiência exige combinar os dez valores e propagar o erro amostral pelas réplicas, o que é outro trabalho.
A estimativa é pontual, sem erro-padrão. Os pesos de replicação que o PUF distribui não foram usados aqui. Os totais e percentuais ponderados são estimativas pontuais, e este post não afirma nada sobre o intervalo de confiança delas.
O que fica
Quando o arquivo é uma amostra com pesos desiguais, contar linha e estimar população são duas contas diferentes sobre a mesma coluna, e as duas estão certas para perguntas diferentes. A aritmética fecha nos dois casos. O que meço determina a resposta. A única regra é declarar o que se mediu.
Fonte: OCDE, PISA 2025 Database. Questionário da escola (CY09_MS_SCH_PUF.sav) e questionário do estudante (CY09_MS_STU_PUF.sav), ambos Public Use File do ciclo CY09. Os arquivos brutos têm sha256 registrado, e a apuração, incluindo a expansão pelos pesos W_NRASCHBWT e W_FSTUWT, é reprodutível a partir deles.